AIエージェント4体に自分のアプリをレビューさせ、指摘の修正まで任せる無料ツールを作った
本記事にはプロモーション(PR)が含まれます。
「高価なAIには指揮とレビューだけをさせて、コードを読む作業は安いAI4体に並列でやらせる」。Xでこの構成のデモが話題になっていました。紹介されていたツールは有料(99ドル〜)で順番待ちでしたが、仕組み自体は Claude Code があれば組めます。そこで自作し、自分のアプリに対して何度も走らせてきました。
この記事は、そのツール agent-canvas の紹介と、実際に使って分かったことの記録です。結論を先に書くと、安いAIの「量」と賢いAIの「まとめ」の組み合わせは確かに深いところまで届きます。ただし、出てきた指摘をそのまま直すのは危ない。それが分かったので、「指摘を疑ってから直す」修正係まで付けて、無料で公開しました。
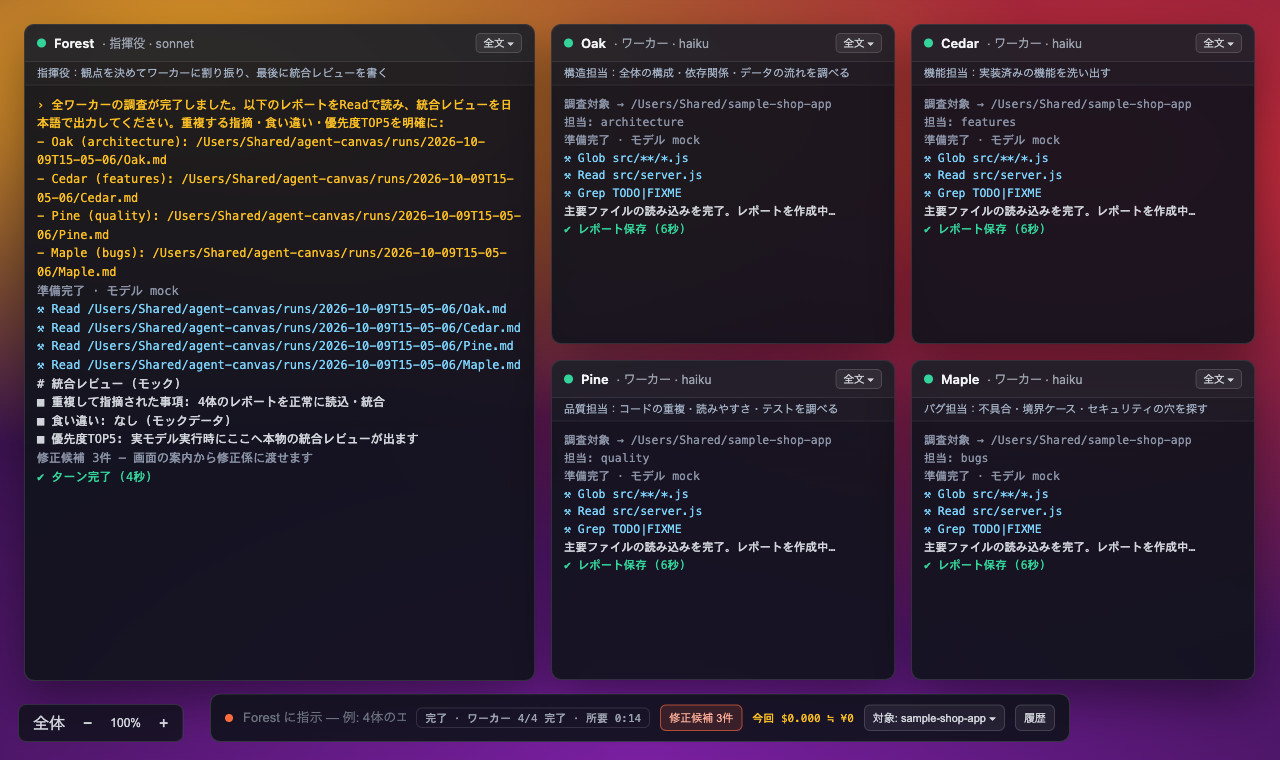
仕組み:役割分担で費用を下げる
- 指揮役(Forest) — 賢いモデル(Claude Sonnet)。指示を解釈してワーカーを動かし、最後に4本のレポートを突き合わせて統合レビューを書きます。自分ではコードを読みません
- ワーカー4体(Oak / Cedar / Pine / Maple) — 安いモデル(Claude Haiku)。構造・機能・品質・バグの担当に分かれ、対象のコードを並列で読んでレポートを出します。読み取り専用で、コードは書き換えません
- サーバー — 4体の完了を検知したら、指揮役に自動で「レポートを読んでまとめて」と依頼します
コードを読むという「量」の仕事を安いモデルに分散し、「判断」だけを高いモデルに残す。人間の組織と同じ発想です。
実測:約3分・約200円で何が返ってくるか
自作の家計簿アプリ(レシートを写真で取り込み、台帳とExcelに自動で反映する Python のツール。テスト96件)に、画面の入力欄から「4体のエージェントでこのコードベースを深掘りして」と送りました。
- 全工程 約3分18秒(ワーカー4体が並列で85〜127秒、統合レビュー36秒)
- 費用は API換算で約1.33ドル(約200円)。うち指揮役が0.54ドル、ワーカー4体が計0.79ドル
- Claude の定額プラン(Pro / Max)で使う場合は、この額が請求されるのではなくプランの利用枠から使われます
統合レビューは「複数のワーカーが指摘した事項(=確度が高い)」「ワーカー間で食い違った点」「優先度TOP5」に整理されて返ってきます。7月に別の業務アプリで試したときは、事前に何度もレビューしていたのに誰も気づかなかった「処理が失敗しても『承認済み』のまま残る」バグを、指揮役が実際のコードを開いて確かめたうえで1位に挙げてきました。
ただし、指摘をそのまま直すのは危ない
家計簿アプリの統合レビューのTOP5を、1件ずつ実際のコードで確かめました。結果はこうです。
- 1件は誤りでした。 「CSVの列が無いと例外で止まる」という指摘は、すでにその例外を捕まえて処理していました
- 優先度の付け方がずれていました。 1位は「AppleScript のインジェクション脆弱性」。ただ、入力は自分のMac上の固定値で、実際の危険は小さいものでした
- いちばん深刻な問題は、TOP5に入っていませんでした。 レビューが指摘したのは手動で実行するスクリプトの弱点でしたが、同じ弱点が「毎日自動で動くスクリプト」にもありました。こちらは壊れた画像が1枚あるだけで、取り込みが止まったまま誰にも気づかれない作りでした
安いモデルの調査は、量は出ますが誤りも混ざります。指摘は「直す候補」であって「直すべきこと」ではない。ここを人かAIが一度疑わないと、誤った指摘まで「修正」してしまいます。
そこで「修正係」を付けた(試験機能)
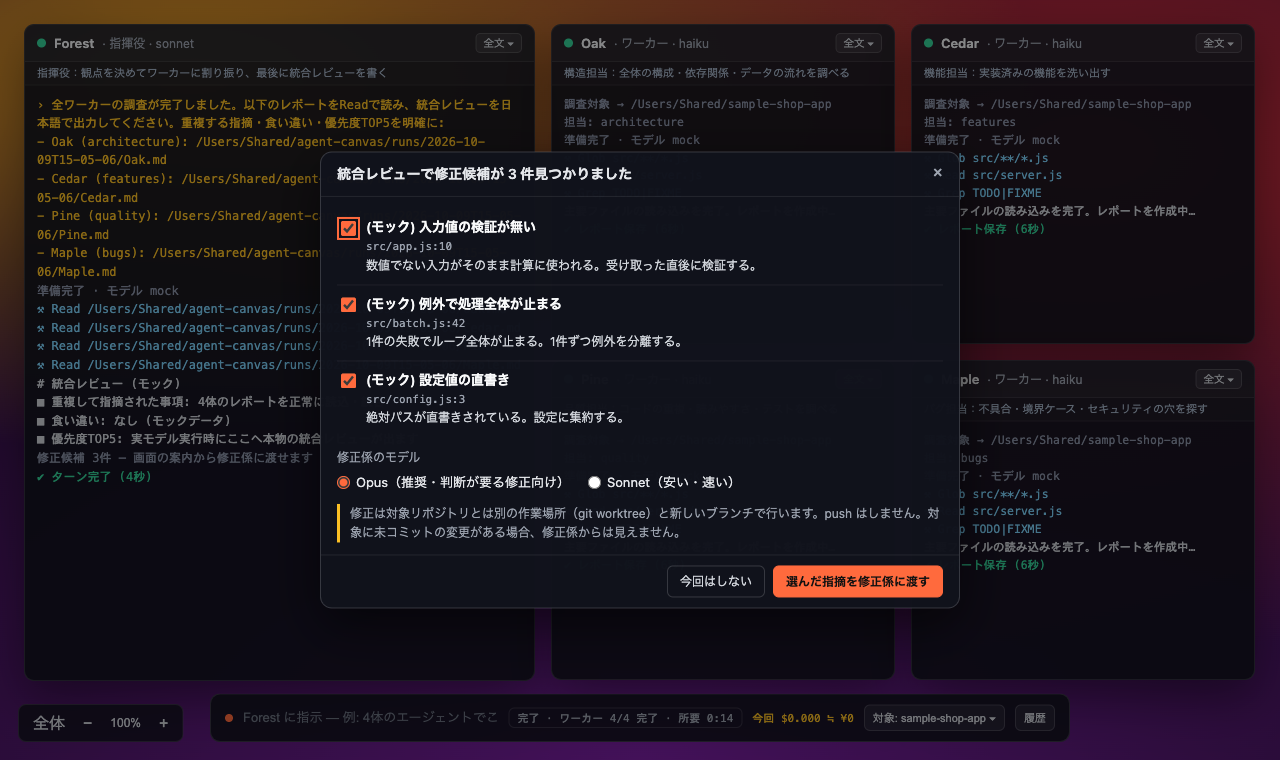
統合レビューが終わると「修正候補が N 件見つかりました」と画面に出ます。直したいものにチェックを入れて渡すと、修正係が次の手順で動きます。
- 各指摘を実際のコードで確かめ、「修正」「誤指摘」「見送り」に判定する
- 同じ弱点を持つ別の経路(自動で動くスクリプトなど)が無いかも確かめる
- 最小限の修正をして、テストを実行する
- 判定の理由・テスト結果・変更ファイルを報告する
作業は、元のフォルダとは別の作業場所と別のブランチで行います。手元のコードには触れず、取り込むかどうかは報告を読んだ自分が決めます。修正係はネットワークに出られず、作業場所の外にも書き込めない状態で動き、push もできません。
作る過程では、「修正係が隔離を抜けて任意のコマンドを動かせる」穴を3つ見つけて塞ぎました(自動のセキュリティレビューで指摘を受け、実際に攻撃を再現して確かめています)。それでも、あなたのコードを書き換えてテストを実行する機能であることに変わりはないので、既定では無効にしてあります。使う場合は内容を理解したうえで、自己責任で有効にしてください。
使い方(無料・オープンソース)
MIT ライセンスで GitHub に公開しています: infosat2000/agent-canvas
git clone https://github.com/infosat2000/agent-canvas.git
cd agent-canvas
npm install
npm run doctor   # 環境チェック
npm run mock     # まずはモデルを呼ばない無料のモックで全体の流れを確認
本番は、ブラウザで http://localhost:4923 を開き、下部の「対象」から調べたいフォルダを選んで、入力欄に指示を送るだけです。修正係を使う場合は CANVAS_FIXER=1 node server.js で起動します。
前提は Node.js 18 以上と、Claude Code の CLI にログインしていること(Pro / Max の定額プラン)。APIキーは要りません。画面はすべて日本語で、実行ごとの費用(ドルと円)と過去の結果を「履歴」で見返せます。
向く人・向かない人
- 向く人: 数千行以上のコードを持っていて、第三者の目のレビューを安く定期的に回したい人。複数のAIを協調させる構成を、動くもので理解したい人
- 向かない人: 数百行の小さなプロジェクト(1回のレビュー依頼で十分です)。Claude の定額プランを持っていない人
おわりに
FOREST LIFE* では、小さな事業や個人の仕事に効く道具を作っています。音声や動画を文字にして、外国語は日本語訳まで付ける Mac アプリ「聞き取り番」もそのひとつです。こうしたAIの使い方を仕事のスキルとして身につけたい方は、未経験からAIエンジニアになる学習ロードマップ もどうぞ。
agent-canvas は Anthropic 非公式のコミュニティツールで、特定の既存製品とは無関係の独自実装です。モデルの利用にかかる費用は利用者の負担です。記載の時間と金額は筆者の実測値(2026年10月時点)です。